Post Mortem · Épisode 14
#14 Scaler sa réponse à incidents — Le cas Algolia
Écouter cet épisode
Épisode 14 · Scaler sa réponse à incidents - Le cas Algolia
 Spotify
 Apple Podcasts
Sommaire
Le passage à l'échelle de la résolution d'incidents à Algolia. Une discussion avec Xavier Grand.
Show Notes
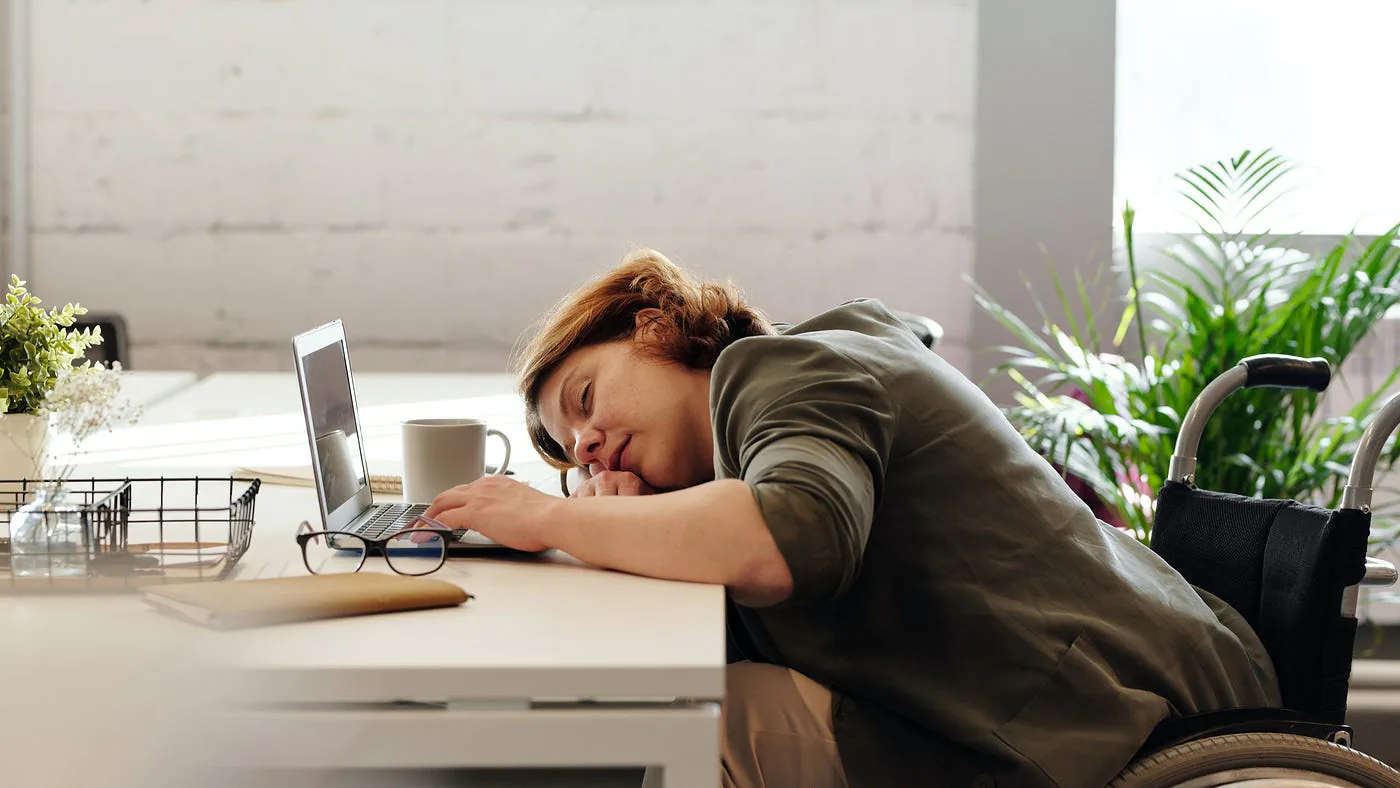
Cette semaine-là, Xavier reçoit plus de 80 alertes la nuit. Impossible de dormir correctement. Il y a forcément quelque chose à faire pour sortir les ingénieurs on-call de cette spirale et éviter une alert fatigue. Mais par où commencer ?
Dans cet épisode, on retrace la façon dont Algolia a réorganisé ses efforts de maintenance opérationnelle à mesure que son moteur de recherche gagne en popularité.
Pour échanger à ce sujet, je reçois Xavier Grand, Software Engineer @ Algolia depuis son incubation à YCombinator en 2014 et aujourd'hui Manager Search.
Nous revenons sur la façon dont Algolia a fait évoluer ses équipes et sa stratégie pour répondre à des outages à mesure que le produit, l'équipe et la codebase prenaient du volume, en particulier :
- Les 3 étapes clés du chemin parcouru par les équipes tech d'Algolia pour gagner en maturité sur la réponse à incidents 🗝
- L'importance d'organiser le transfert de connaissances des experts de la codebase vers les nouveaux collaborateurs et comment accompagner les nouveaux venus pour leur premier cycle on-call 🚨📊👩💻
- De l'importance de monitorer les causes et non les symptômes 🤒
… et bien d'autres!
Ressources
- La recommandation de Xavier; Le Google SRE Workbook, excellente ressource (et gratuite) pour animer un club de lecture avec votre équipe et réfléchir ensemble sur des bonnes pratiques transposables dans votre organisation.
- Pour un exemple de blog post mortem d'Algolia, je recommande cet excellent article de blog sur leur gestion de l'attaque Salt en mai 2020.
Retrouvez l’intégralité des épisodes de Post Mortem sur le page du podcast 👇🔊