OLMoTrace: Tracing Language Model Outputs Back to Trillions of Training Tokens
In this reference
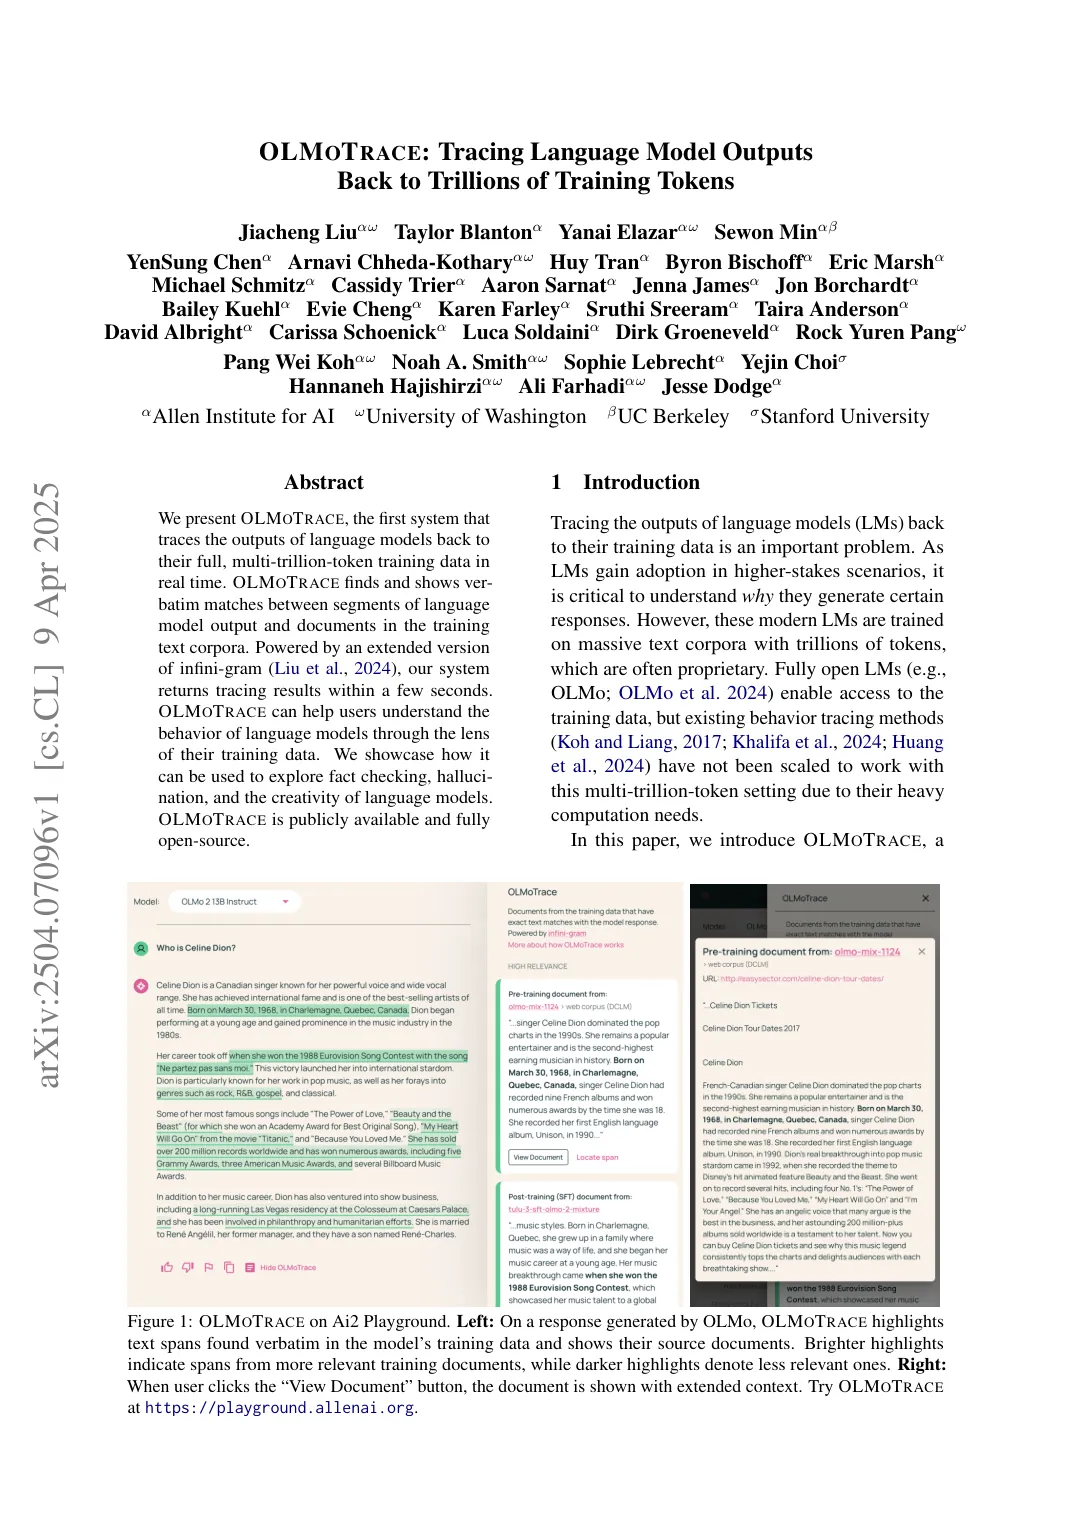
OLMoTrace finds verbatim matches between spans of a language model's output and documents in its multi-trillion-token training data, and shows them in real time.
Cite the original work
Jiacheng Liu & Taylor Blanton & Yanai Elazar & Sewon Min & YenSung Chen & Arnavi Chheda-Kothary & Huy Tran & Byron Bischoff & Eric Marsh & Michael Schmitz & Cassidy Trier & Aaron Sarnat & Jenna James & Jon Borchardt & Bailey Kuehl & Evie Cheng & Karen Farley & Sruthi Sreeram & Taira Anderson & David Albright & Carissa Schoenick & Luca Soldaini & Dirk Groeneveld & Rock Yuren Pang & Pang Wei Koh & Noah A. Smith & Sophie Lebrecht & Yejin Choi & Hannaneh Hajishirzi & Ali Farhadi & Jesse Dodge (9 April 2025). OLMoTrace: Tracing Language Model Outputs Back to Trillions of Training Tokens [Research paper]. arXiv. https://arxiv.org/abs/2504.07096v1
View BibTeX
@misc{olmotrace,
  author = {Jiacheng Liu and Taylor Blanton and Yanai Elazar and Sewon Min and YenSung Chen and Arnavi Chheda-Kothary and Huy Tran and Byron Bischoff and Eric Marsh and Michael Schmitz and Cassidy Trier and Aaron Sarnat and Jenna James and Jon Borchardt and Bailey Kuehl and Evie Cheng and Karen Farley and Sruthi Sreeram and Taira Anderson and David Albright and Carissa Schoenick and Luca Soldaini and Dirk Groeneveld and Rock Yuren Pang and Pang Wei Koh and Noah A. Smith and Sophie Lebrecht and Yejin Choi and Hannaneh Hajishirzi and Ali Farhadi and Jesse Dodge},
  title = {{OLMoTrace: Tracing Language Model Outputs Back to Trillions of Training Tokens}},
  howpublished = {arXiv},
  url = {https://arxiv.org/abs/2504.07096v1},
  year = {2025}
}