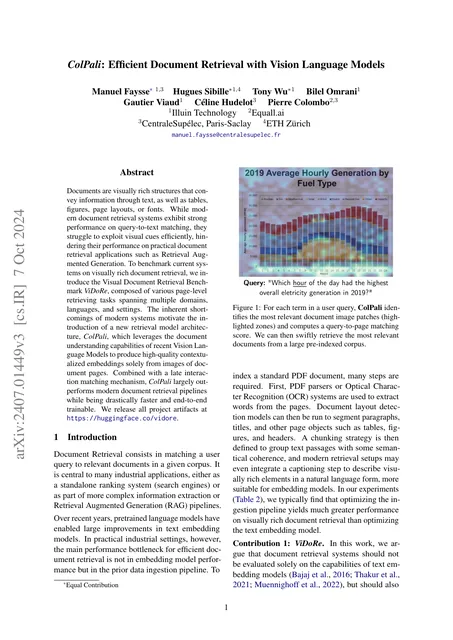
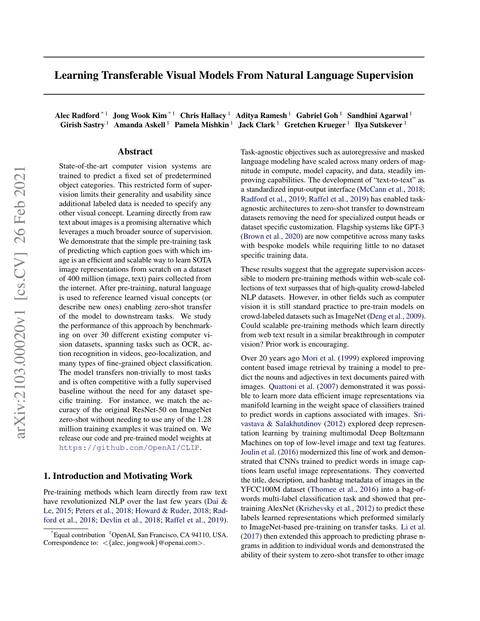
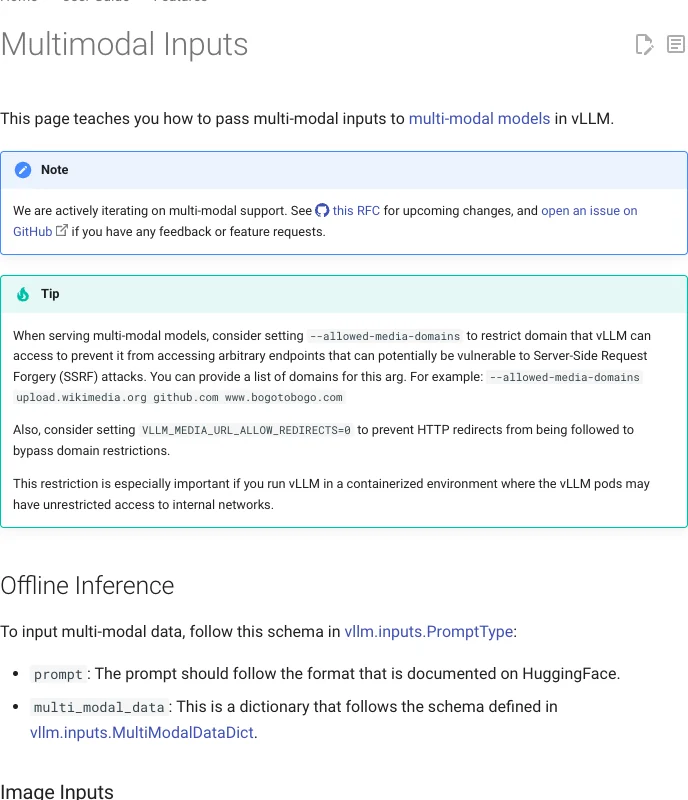
Multimodal Inputs
In this reference
Documentation for sending multimodal inputs to vLLM.
Cite the original work
Multimodal Inputs [Documentation]. vLLM. https://docs.vllm.ai/en/stable/features/multimodal_inputs/
View BibTeX
@misc{multimodal_inputs,
  title = {{Multimodal Inputs}},
  howpublished = {vLLM},
  url = {https://docs.vllm.ai/en/stable/features/multimodal_inputs/}
}